算力革新与生态构建 从夸娥万亿集群到摩尔线程三大AI工厂矩阵的WAIC 2026观察
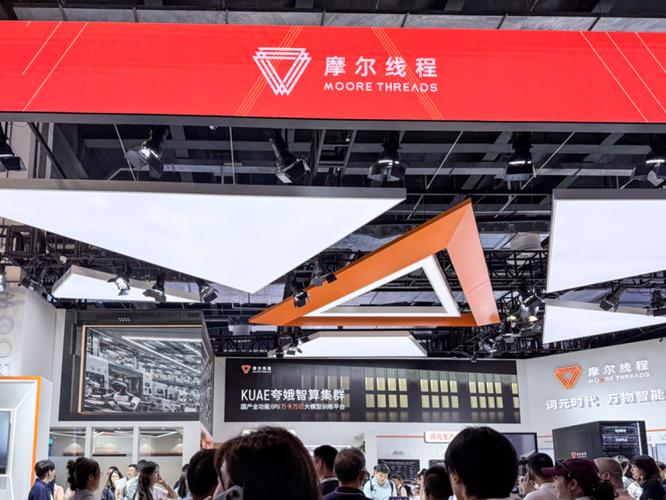
2026年世界人工智能大会(WAIC 2026)上,中国AI算力基础设施迎来标志性时刻。夸娥万亿大模型集群正式亮相,以其超大规模参数与高效并行训练能力,展示了通向通用人工智能(AGI)的算力底座新高度。与此摩尔线程重磅展出三大AI工厂矩阵,从底层芯片、系统集群到行业应用,勾勒出算力普惠与产业赋能的完整蓝图。这两大发布共同指向一个趋势:AI竞争已从单点模型突破升级为“大集群+全栈工厂”的体系化较量。
夸娥万亿大模型集群的核心亮点在于“万亿级”与“集群化”的双重突破。该集群采用先进的高速互联架构与液冷散热方案,支持万亿参数规模的稠密模型或更大规模的稀疏专家模型高效训练。通过自研的分布式训练框架与通信优化算法,集群实现了近乎线性的扩展效率,将万亿参数模型的训练周期从数月压缩至数周,同时功耗比优于行业平均水平。集群还内置了容错调度与弹性资源管理机制,即便部分节点出现故障,训练任务仍可无缝迁移,保障长时间稳定运行。这一集群的亮相,意味着中国在超大模型训练基础设施上已具备对标国际顶尖水平的能力,也为科研机构与头部企业提供了开放式的超大规模算力试验场。
作为国内全功能GPU的代表企业,摩尔线程在WAIC 2026上系统性展示了其AI工厂矩阵的战略布局。这一矩阵由三大部分构成,旨在覆盖AI算力从生产、调度到消费的全链条。
第一,算力芯片工厂。摩尔线程展出了新一代全功能GPU芯片及计算加速卡,采用先进的制程工艺与创新架构,在FP8/FP16等低精度训练与推理场景下实现能效比大幅提升,同时兼容主流AI框架与算子库。这些芯片构成了AI工厂的“发动机”,为不同规模的集群提供核心算力。
第二,集群系统工厂。基于自研芯片与高速互连技术,摩尔线程提供从单机八卡服务器到千卡、万卡级智算集群的完整解决方案。其集群系统支持异构计算资源池化管理,并集成自动化运维、模型压缩与推理加速工具链,帮助用户将分散的算力整合为稳定、高效的“算力电网”。值得一提的是,夸娥万亿集群很可能采用了摩尔线程的GPU方案,双方在超大规模训练领域形成了协同效应。
第三,行业应用工厂。摩尔线程强调“算力即服务”理念,通过预置的行业大模型模板、低代码微调工具与端到端部署管道,让制造、医疗、金融、教育等领域的客户能够快速构建专属AI应用。该工厂还整合了数字孪生、AIGC内容生成及边缘推理能力,推动AI从云端走向车间、诊室与课堂。
夸娥万亿大模型集群与摩尔线程三大AI工厂矩阵的同台亮相,形成了从“极致规模”到“产业渗透”的互补图景。前者证明了中国在超大规模训练上的技术雄心与工程能力,后者则提供了让这种能力转化为行业生产力的方法论。更长远的看点在于,两大体系的开放程度——夸娥集群是否会向中小AI团队开放配额?摩尔线程的AI工厂是否会催生算力期货与模型即服务的新商业模式?这些问题的答案,将决定中国AI算力生态能否从单点领先走向群体繁荣。
WAIC 2026展示的不只是硬件参数的堆叠,更是AI生产关系的重塑。当万亿集群与AI工厂矩阵协同发力,人工智能的规模定律与工程定律将加速汇流,推动大模型从震撼人心的技术演示,变成水、电一样的基础生产要素。而谁能在这个过程中扮演更可及的算力运营商与产业连接者,谁就掌握了下一个十年的增长引擎。
如若转载,请注明出处:http://www.jinyichengjr.com/product/31.html
更新时间:2026-09-18 04:45:04